Oferta vigente
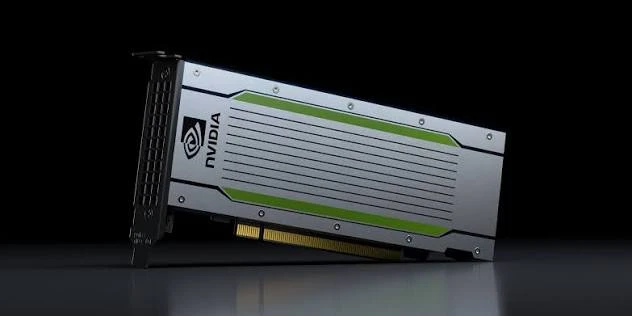
EssencialT4 · 16 GB VRAM
VM básica inclusa
- 2 vCPU
- 8 GB de RAM
- 50 GB de NVMe
- Rede de 1 Gbps
- 1 IP público
a partir deR$990/mês
GPU · IA, visão computacional e render
Placa NVIDIA exclusiva da sua empresa, em datacenter no Brasil. Mensalidade fixa em real, sem cobrança por hora e sem taxa de saída de dados.
Ambientes prontos
Placa e servidor já dimensionados. Escolha um e ajuste o que precisar.
Oferta vigente
VM básica inclusa
Toque no ambiente para escolher. Deslize para comparar
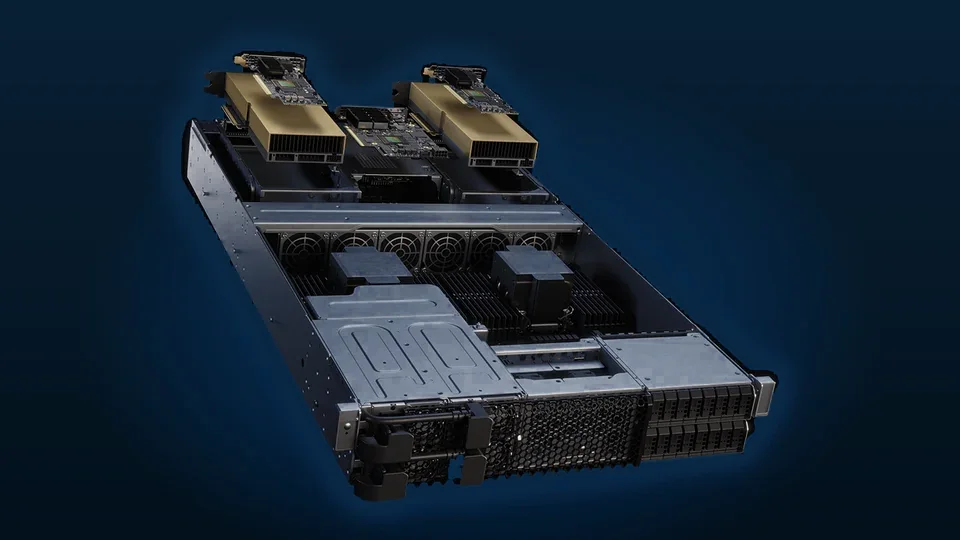
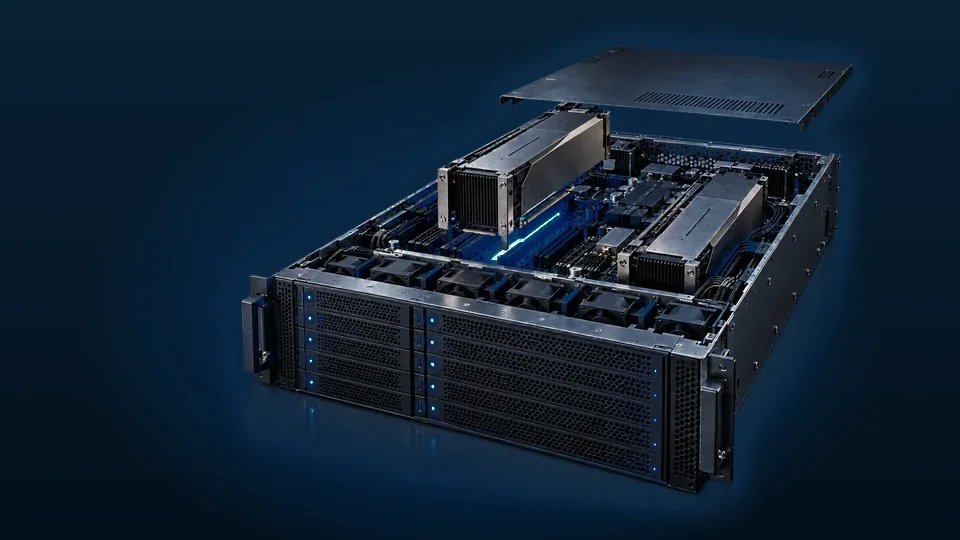
2× T42× 16 GB VRAM
R$ 1.690/mês
Entrega em até 15 dias úteis
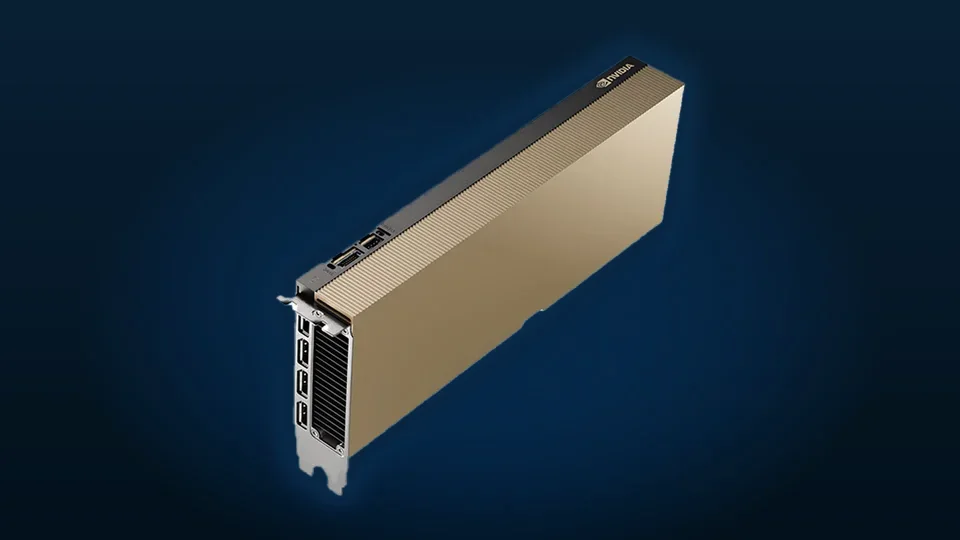
RTX PRO 450032 GB VRAM
R$ 4.990/mês
Entrega em até 15 dias úteis
L40S48 GB VRAM
R$ 7.990/mês
Entrega em até 15 dias úteis
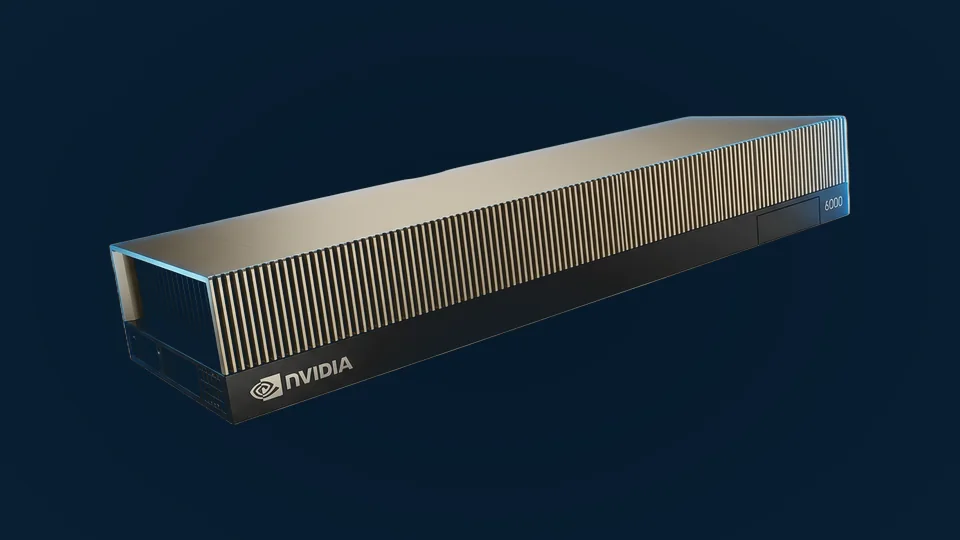
RTX PRO 600096 GB VRAM
R$ 12.990/mês
Entrega em até 15 dias úteis
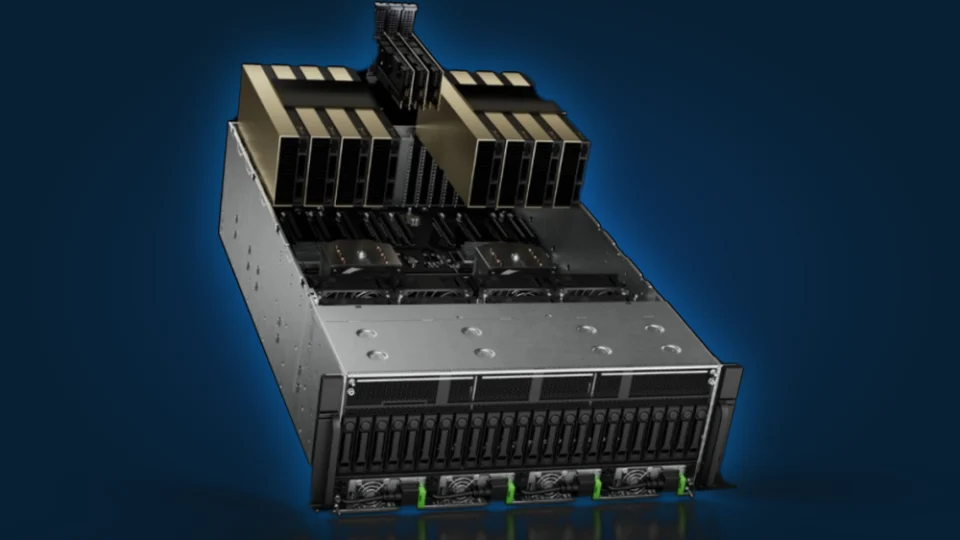
H200 NVL141 GB VRAM
R$ 26.990/mês
Entrega em até 15 dias úteis
Parta do ambiente escolhido e some o que a operação precisa.
Produção (L40S)
Em todo ambiente,
sem custo extra
Casos de uso
Comece pela tarefa. A placa sugerida é um ponto de partida; o tamanho do modelo e o número de usuários confirmam a escolha.
Modelo de 7 a 8B para a equipe e transcrição de áudio, com os dados no Brasil.
Câmeras, contagem, OCR e leitura de placa em vários fluxos de vídeo.
RAG: o modelo responde consultando manuais, contratos e a base da empresa.
FLUX e Stable Diffusion cabem em 32 GB; vídeo por IA pede a L40S.
Blender, V-Ray, Redshift, Unreal; CAD e BIM acessados de qualquer lugar.
LLM de 70B a 120B e ajuste fino com os dados da empresa.
Antes de escolher a placa
Diga o que vai rodar. A conta mostra quanta memória de vídeo a carga pede, quais placas da OPEN atendem e quanto custa por mês. O especialista confirma antes da proposta.
O que vai fazer
Precisão quantização
Contexto texto que o modelo lê de uma vez
Mil tokens são umas 750 palavras em inglês. Chat simples: 4 a 8 mil. Documentos anexados (RAG): 16 a 32 mil.
Cada conversa simultânea guarda a sua própria memória de trabalho na placa.
Tamanho da cena memória que ela usa na placa
Serve para mostrar o efeito de juntar placas. Placa diferente da sua muda a base.
Memória estimada
0GB
Placas da OPEN que atendem
Estimativa para planejar. O número real depende do motor (vLLM, llama.cpp, TensorRT-LLM), do lote e da configuração. Preços mensais "a partir de", os mesmos da página: nos ambientes prontos, placa e servidor juntos; a T4 avulsa vem com a VM básica. As demais placas e quantidades, sob consulta.
Projeto sob medida
Modelo, número de usuários, treino ou inferência. Vale para várias placas, cluster ou carga fora do padrão.
Confere a conta da calculadora com a sua carga real e indica placa, servidor e rede.
Mensalidade fixa em real e o prazo de entrega da placa.
Servidor pronto no datacenter, com especialistas 24/7. Você instala drivers, CUDA e seus contêineres.
Um especialista responde em até 1 hora, no horário comercial.
Fale com a OPEN
Converse com um especialista e receba uma proposta sob medida para a sua operação. Sem compromisso.
Para decidir com clareza
Conte qual modelo roda e quanto paga hoje. Indicamos a placa e comparamos com a sua fatura.
Dimensionar meu ambiente →Não. A GPU fica dedicada a você 24 horas por dia, por uma mensalidade fixa em real.
Depende do modelo. Como referência geral: um modelo de 7 bilhões de parâmetros quantizado (comprimido para usar menos memória) roda em 16 GB; um de 13 bilhões pede cerca de 24 GB; um de 70 bilhões costuma pedir 48 GB ou mais. Treino pede bem mais que inferência. Conte o que vai rodar e indicamos a placa.
Não automaticamente. Cada GPU tem a própria memória; só aplicações preparadas para várias placas dividem o modelo entre elas. Para inferência comum, o que vale é a memória da maior placa.
A placa T4 de 16 GB e uma VM básica com 2 vCPU, 8 GB de RAM e 50 GB de NVMe, com rede de 1 Gbps e IP público. Nas outras placas, o servidor é dimensionado à parte.
Nos dois. A GPU é anexada a uma VM ou instalada num bare metal, conforme o projeto.
Não. O servidor fica num dos datacenters da OPEN no Brasil: Santana de Parnaíba, Vinhedo e Fortaleza.